博客
阅读 RLinf 的工程实践、系统优化与模型集成文章。
文章
RLinf × MUSA:在摩尔线程 S5000 上复现 WoVR
RLinf Team
- 具身智能
- 系统
RLinf x SGLang:Cosmos3 从模型微调到高效评测的全流程集成实践分享
RLinf Team & SGLang Team
- 具身智能
- 系统
RLinf × WorldLoop:用零训练 VLM 奖励扩展 WoVR 世界模型强化学习
RLinf Team
- 具身智能
为具身智能的“ImageNet 时刻”按下加速键:RLinf 为 BEHAVIOR 带来 25 倍系统优化
RLinf Team
- 具身智能
- 系统
智能体落地“最后一公里”初探之Cursor在线强化学习
RLinf Team
- 智能体
与 VeRL 的对比
RLinf Team
- 系统
没有找到匹配的文章。
论文
 OSDI 2026
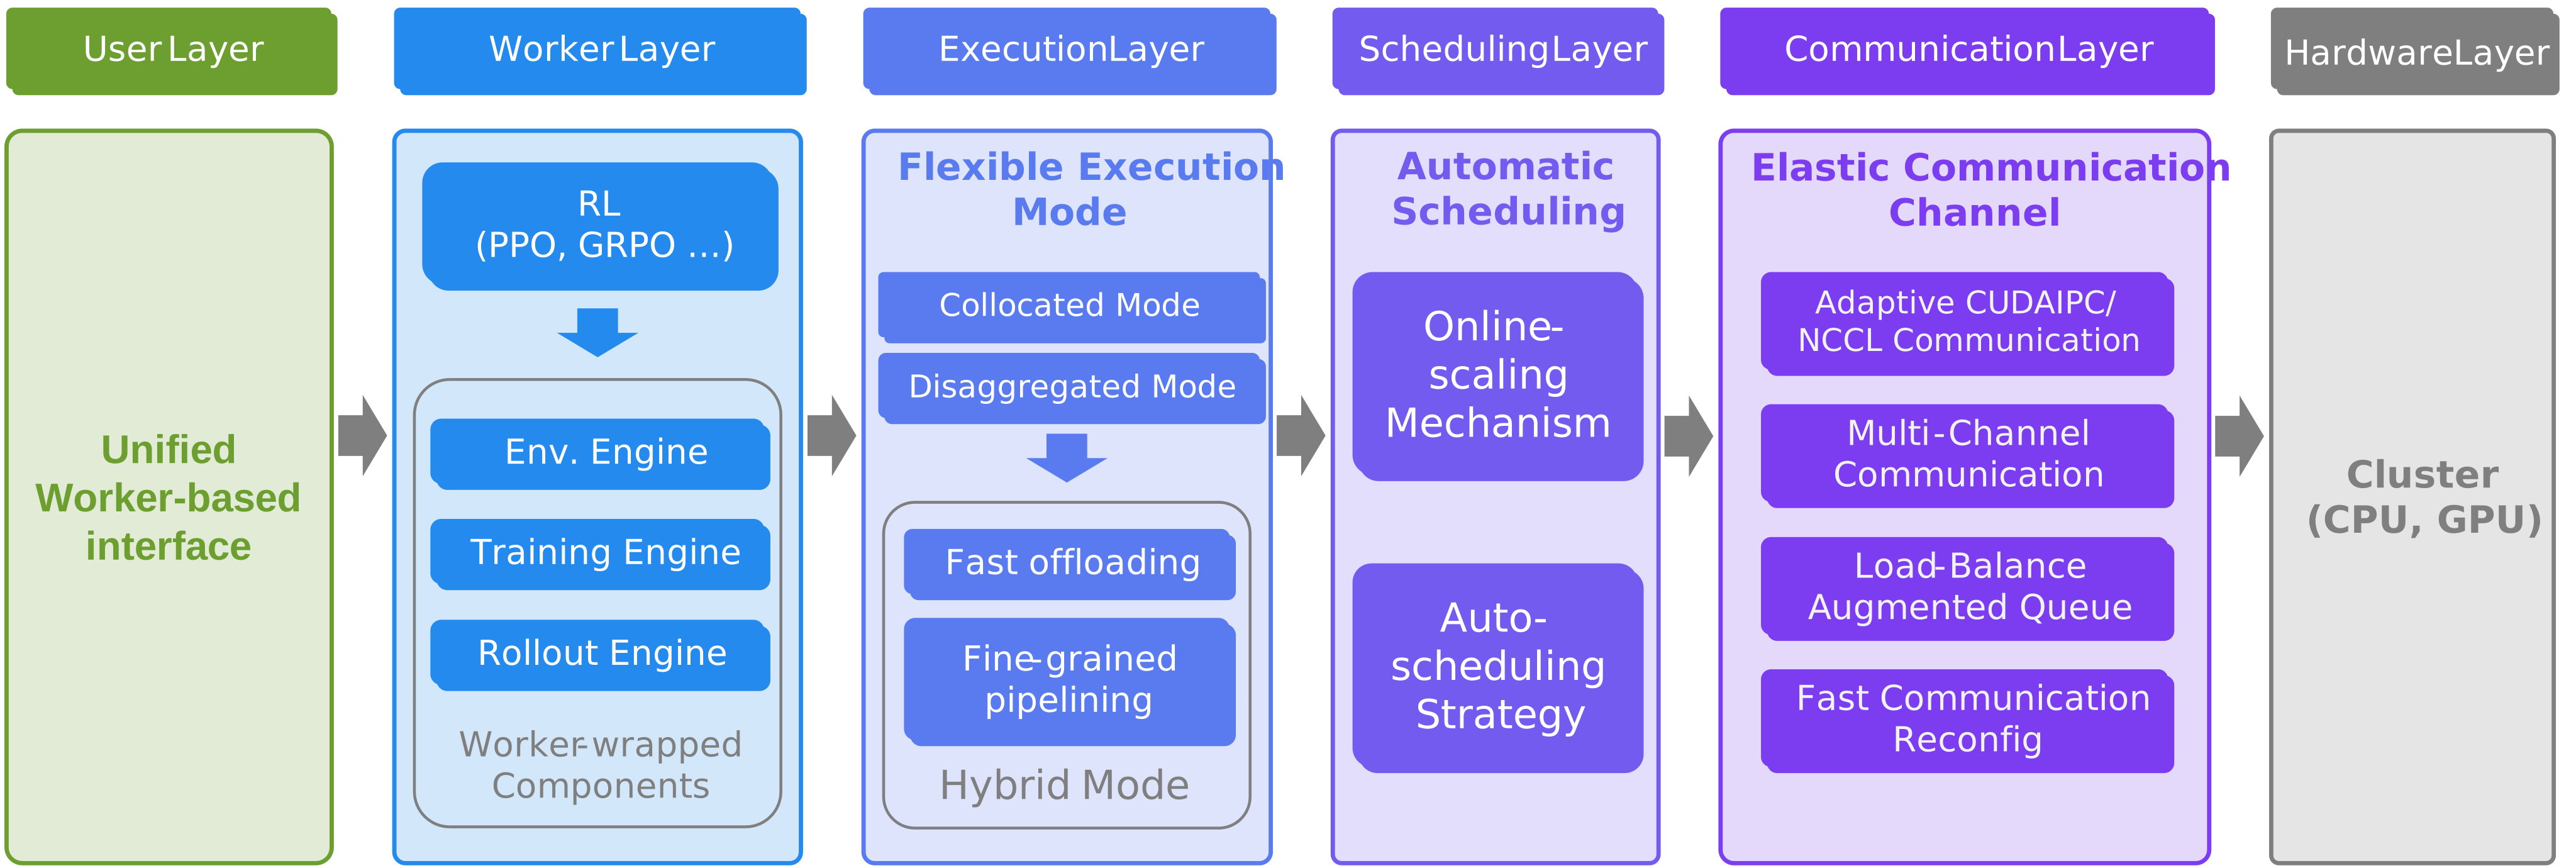
RLinf: Flexible and Efficient Large-scale Reinforcement Learning via Macro-to-Micro Flow Transformation
灵活高效的大规模 RL 系统。
(在新标签页打开)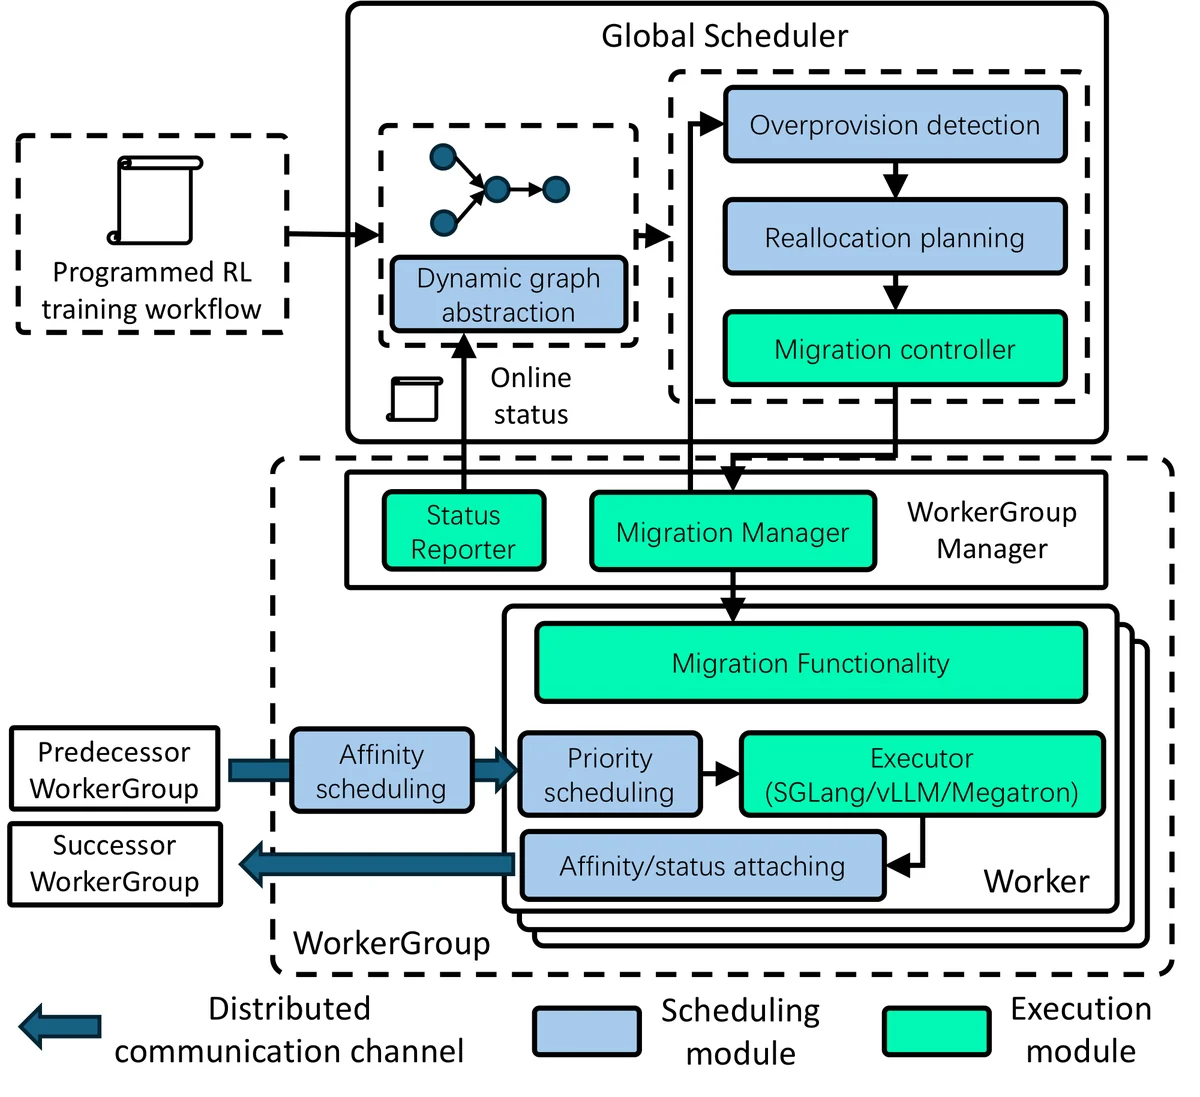 OSDI 2026
DynaRL: Flexible and Dynamic Scheduling of Large-Scale Reinforcement Learning Training
大规模强化学习训练的灵活动态调度。
(在新标签页打开)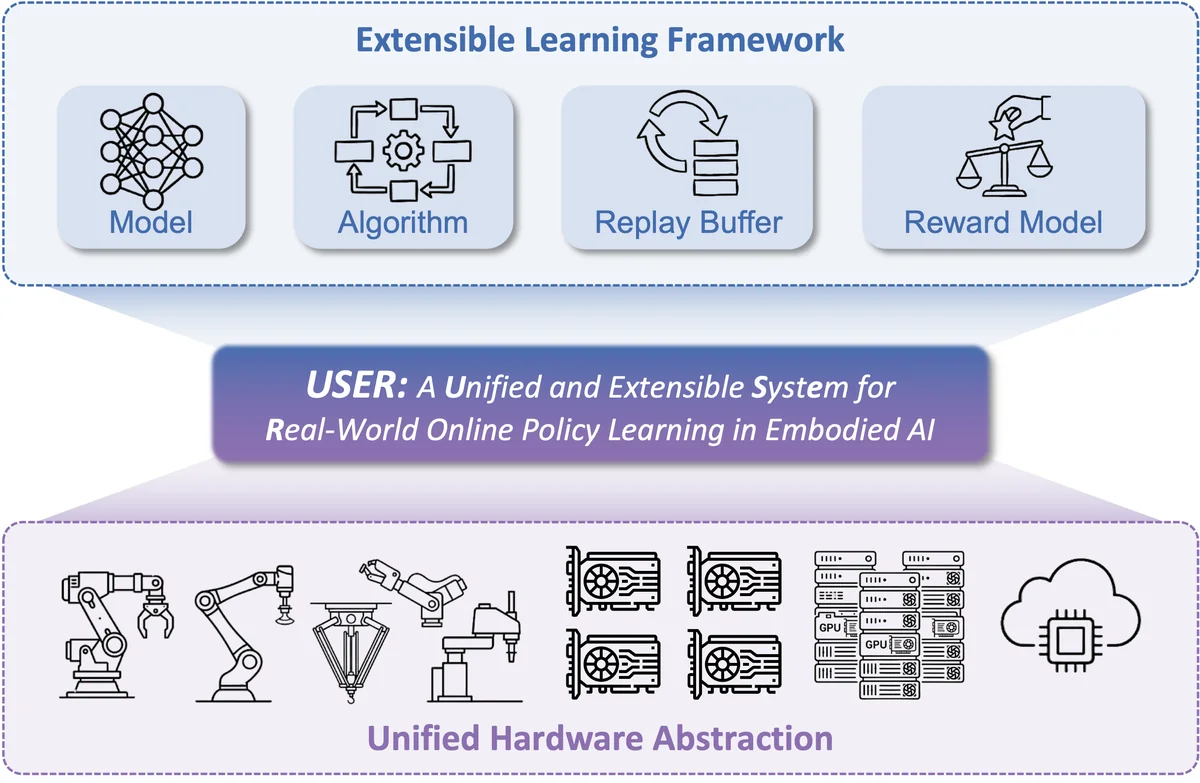 RSS 2026
RLinf-USER: Unified System for Real-world Online Policy Learning
统一真机在线策略学习系统。
(在新标签页打开)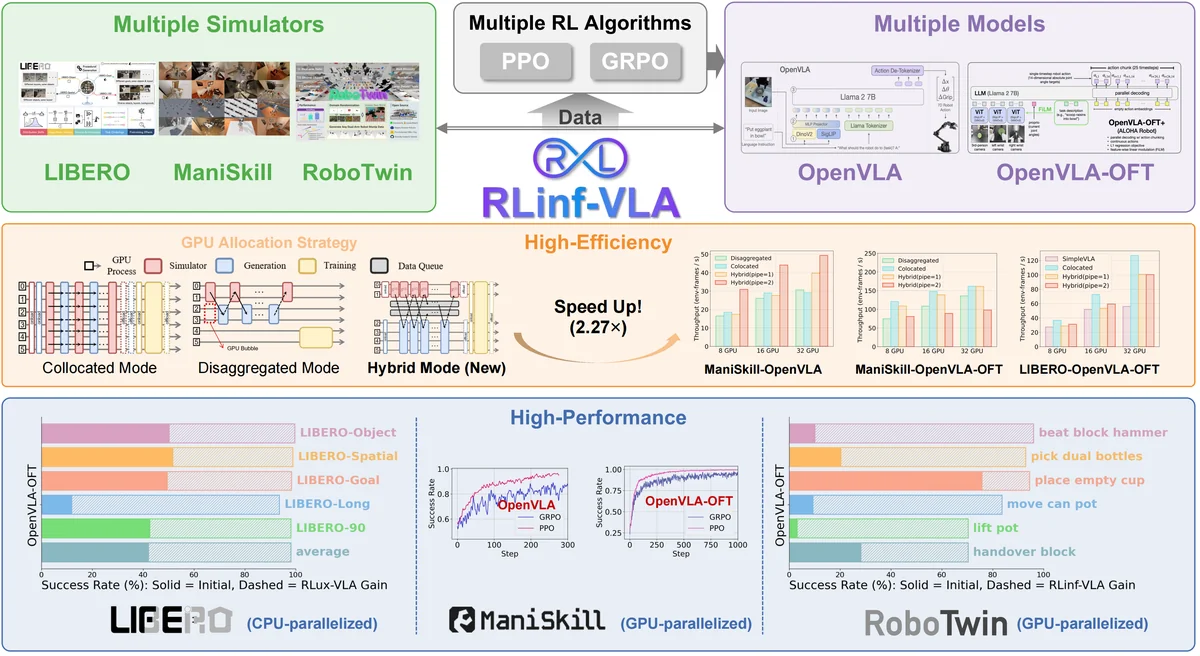 RSS 2026
RLinf-VLA: A Unified and Efficient Framework for VLA+RL Training
VLA+RL 统一框架。
(在新标签页打开)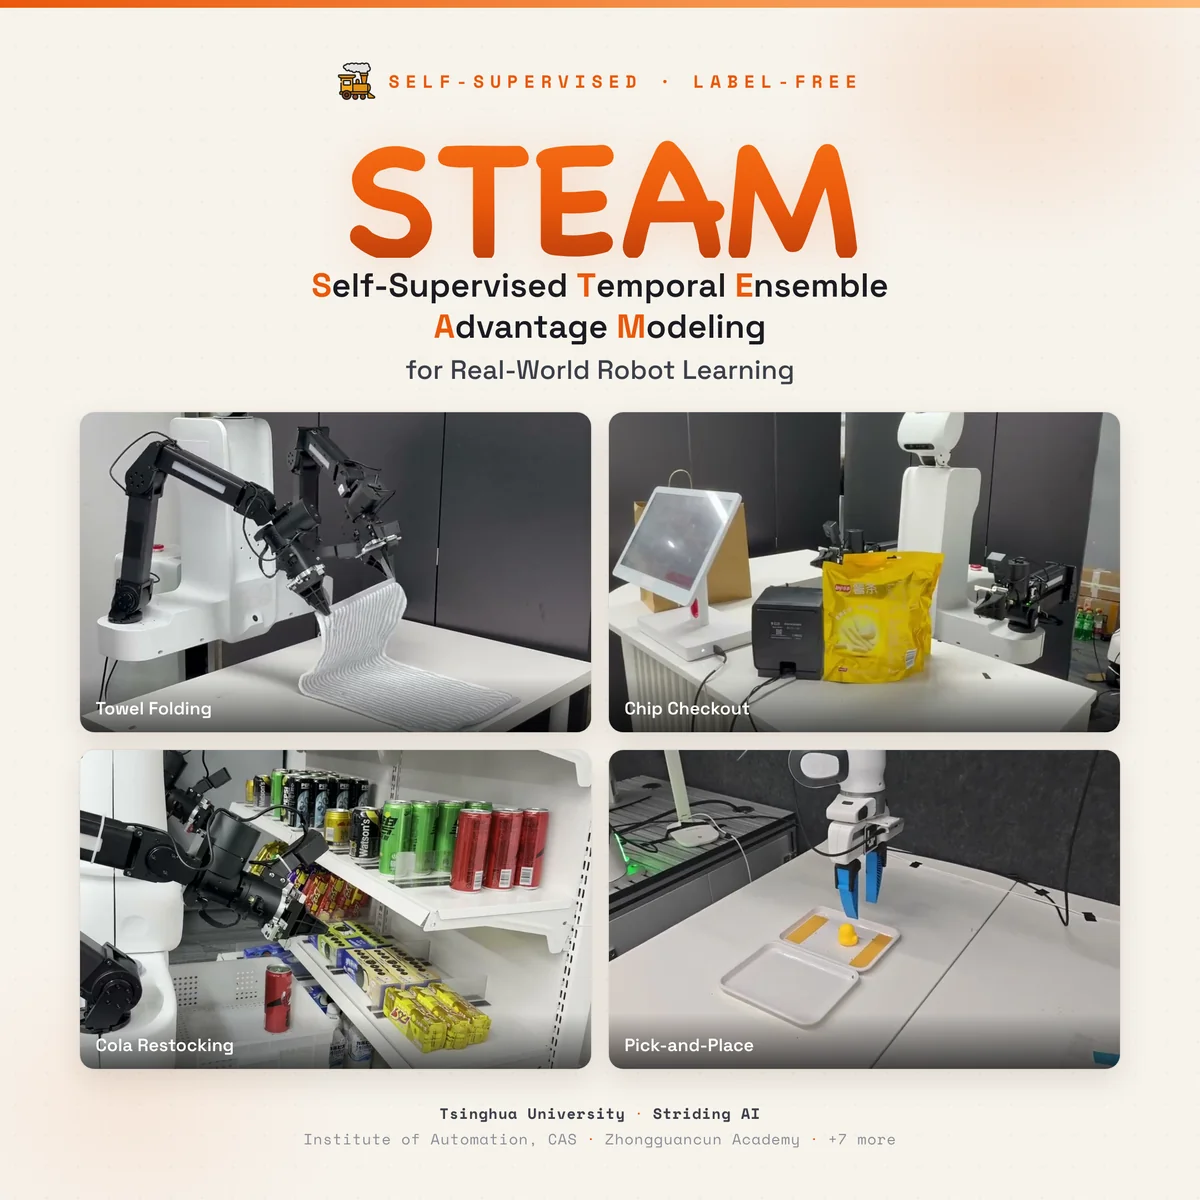 arXiv
STEAM: Self-Supervised Temporal Ensemble Advantage Modeling for Real-World Robot Learning
面向真实机器人学习的自监督时序集成优势建模。
(在新标签页打开)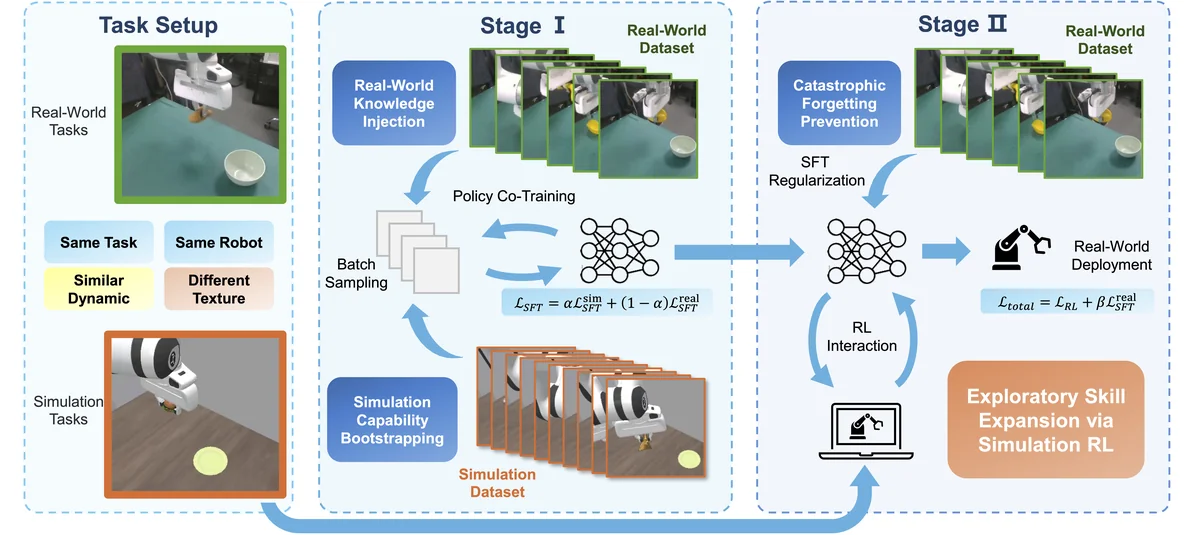 arXiv
Beyond Imitation: Reinforcement Learning-Based Sim-Real Co-Training for VLA Models
基于强化学习的仿真-真实协同训练 VLA 模型。
(在新标签页打开)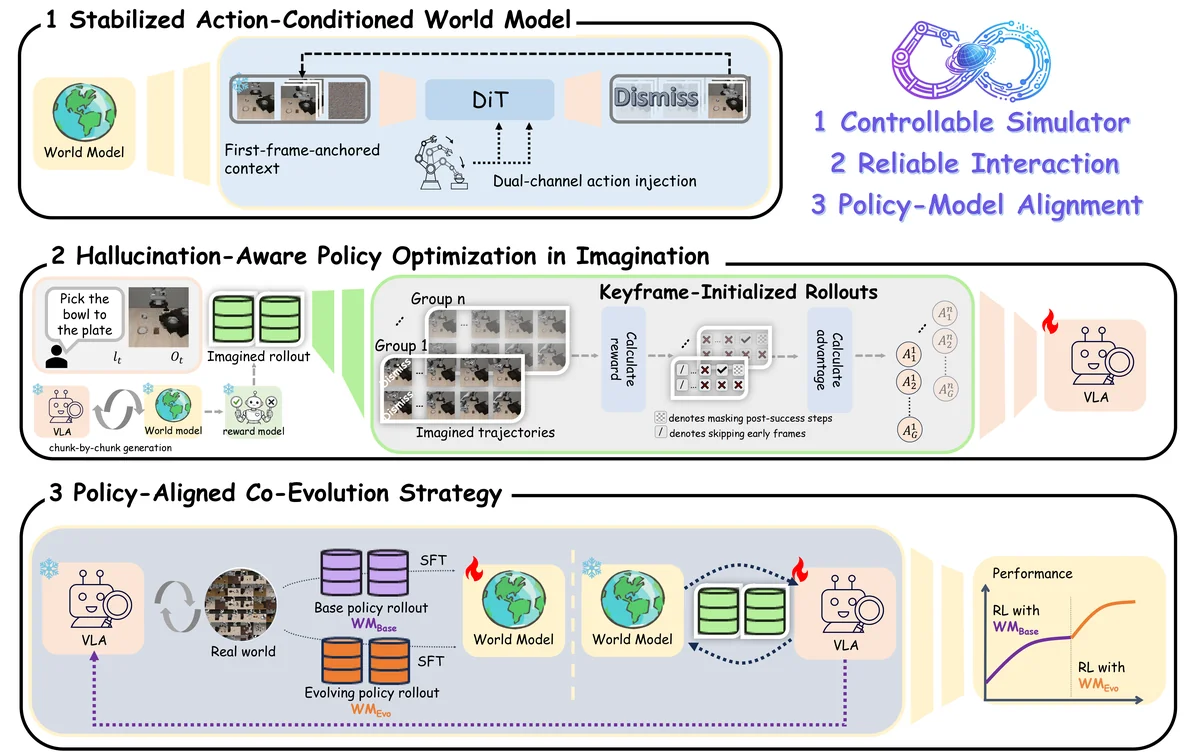 arXiv
WoVR: World Models as Reliable Simulators for Post-Training VLA Policies with RL
基于世界模型的 VLA 模型强化学习微调。
(在新标签页打开)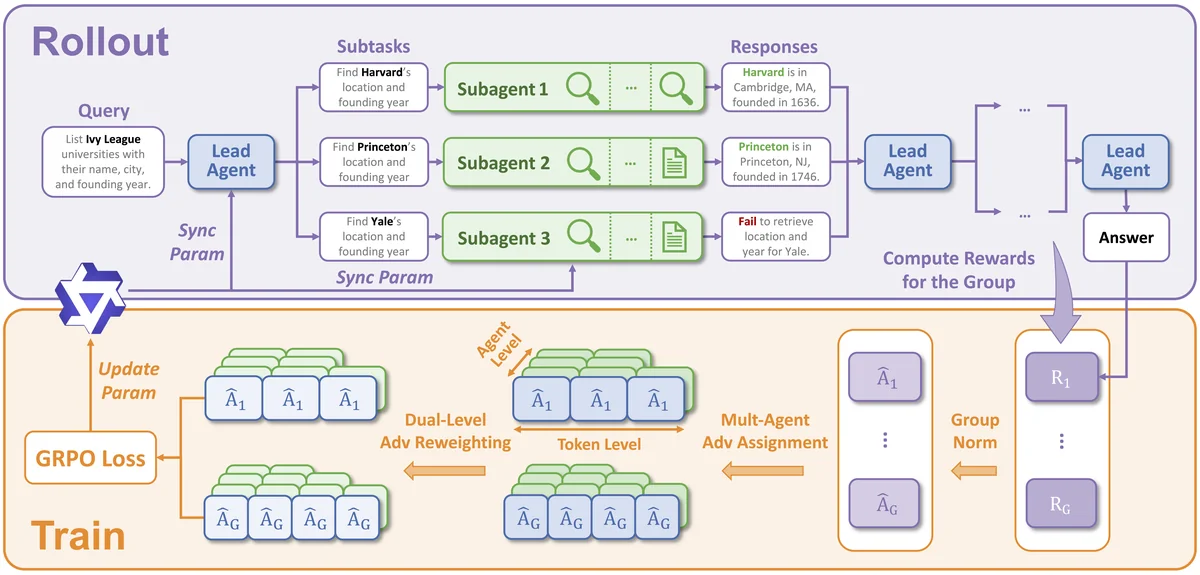 arXiv
WideSeek-R1: Exploring Width Scaling for Broad Information Seeking via Multi-Agent Reinforcement Learning
通过多智能体强化学习探索用于广泛信息检索的宽度扩展方法。
(在新标签页打开)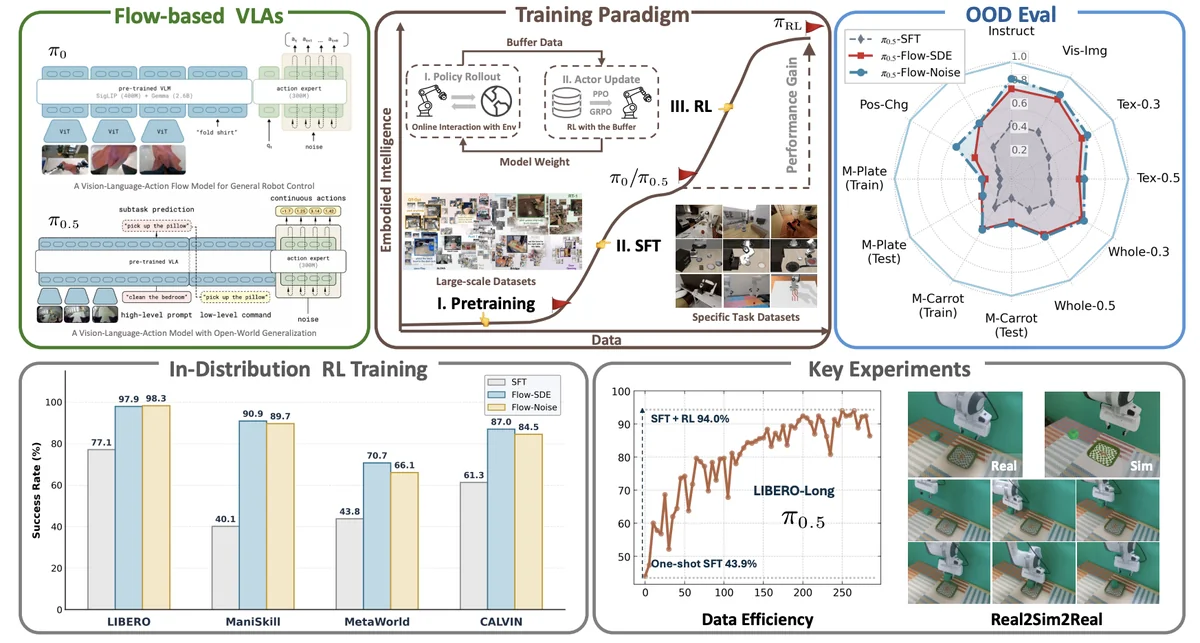 arXiv
πRL: Online RL Fine-tuning for Flow-based Vision-Language-Action Models
基于流的 VLA 模型在线 RL 微调。
(在新标签页打开)